
Сбой системы (System Failure) — состояние, при котором информационная система, ее компонент или сервис полностью либо частично перестает выполнять предусмотренные функции или выполняет их некорректно.
Сбой может затронуть один сервер, приложение, сетевой сегмент или весь комплекс ИТ-систем. Иногда он длится несколько секунд и почти незаметен для пользователей. В других случаях ключевые процессы компании останавливаются на часы.
Поэтому сбой нельзя рассматривать только как техническую проблему. Он связан с информационной безопасностью и непрерывностью бизнеса. При серьезном отказе сотрудники могут потерять доступ к данным, сервисы — стать недоступными, а информация — повредиться.
Особенно существенны последствия сбоев критически важных компонентов инфраструктуры. Чем сильнее бизнес-процессы зависят от цифровых систем, тем заметнее влияние даже короткого простоя.
Что такое сбой системы
Системный сбой возникает, когда система перестает работать в соответствии с предусмотренным режимом. Она может полностью остановиться или сохранить только часть функций.
Например, корпоративный портал продолжает открываться, но перестает сохранять документы. Формально сервис доступен, однако одна из его важных функций не работает.
По длительности сбои условно можно разделить на кратковременные и продолжительные. Кратковременный сбой иногда устраняется автоматически. Серьезный отказ может потребовать вмешательства администраторов, переключения на резервную инфраструктуру или восстановления данных из резервной копии.
По масштабу последствия также различаются. В одном случае перестает отвечать отдельный компонент. В другом отказ одного узла запускает цепочку проблем и затрагивает несколько систем.
Важно различать ошибку, сбой и аварию. Ошибка может существовать внутри системы и не сразу влиять на предоставляемую функцию. Сбой уже проявляется нарушением работы. Аварией обычно называют более серьезное событие с заметными последствиями.
Точные границы между этими понятиями зависят от используемой методики и внутренних регламентов организации.
Какие системы могут столкнуться со сбоем
Практически любая ИТ-система может частично или полностью потерять работоспособность. Это относится как к офисной инфраструктуре, так и к промышленным и технологическим комплексам.
Сбои могут возникать в следующих объектах:
- серверах и системах хранения данных;
- операционных системах;
- корпоративных приложениях;
- базах данных;
- сетевом оборудовании;
- средствах информационной безопасности;
- облачной инфраструктуре;
- системах резервного копирования;
- промышленных и технологических системах.
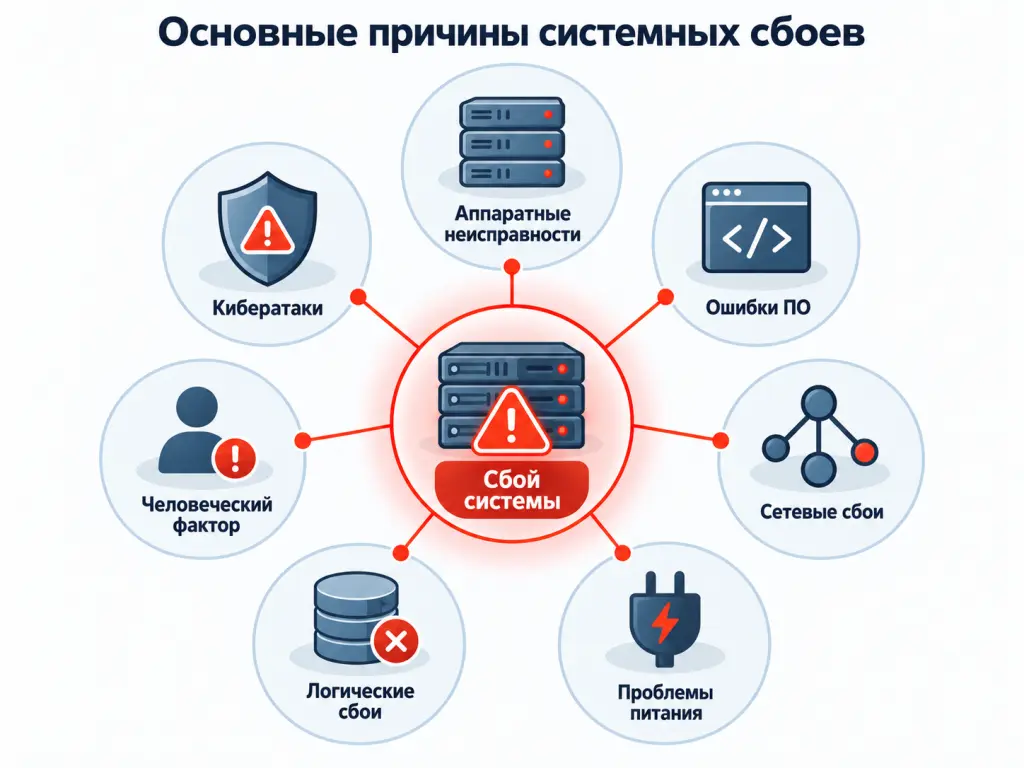
Отказ одного объекта может повлиять на несколько зависимых сервисов. Например, проблема с системой хранения одновременно способна затронуть виртуальные машины, базы данных и приложения.
В современной инфраструктуре зависимости между компонентами могут быть сложными. Пользователь работает с одним приложением, хотя за ним могут стоять десятки внутренних сервисов.
Поэтому поиск причины сбоя не всегда сводится к обнаружению одного неисправного сервера или приложения.
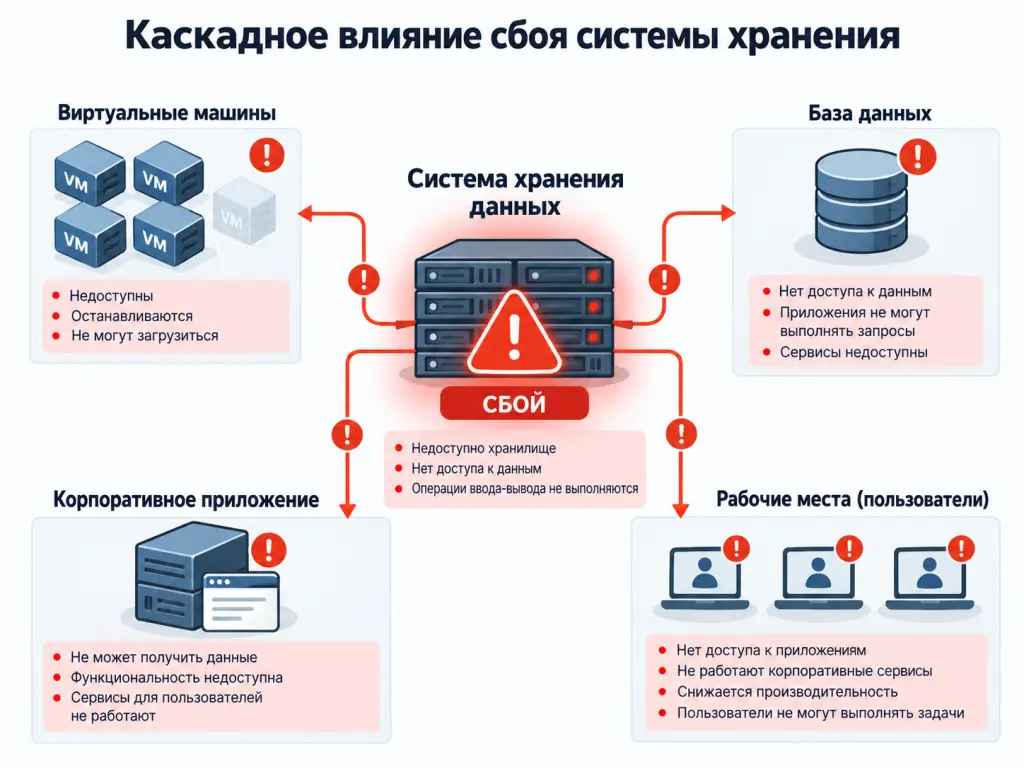
Основные причины сбоев систем
Причина сбоя не всегда очевидна. Иногда проблема начинается с небольшой ошибки, а затем затрагивает зависимые компоненты.
При анализе важно определить не только последний отказавший узел, но и первопричину события.
Аппаратные неисправности
Оборудование имеет ограниченный ресурс и может выходить из строя. Повреждаются диски, блоки питания, сетевые интерфейсы, контроллеры и другие компоненты.
Сам по себе отказ оборудования не обязательно приводит к остановке сервиса. Последствия зависят от архитектуры.
Если компонент зарезервирован, система может переключиться на резервный узел. При отсутствии резервирования отказ одного компонента способен остановить критически важный сервис.
Особое значение имеют единые точки отказа — компоненты, потеря которых нарушает работу всей системы или ее существенной части.
Одна из задач отказоустойчивой архитектуры — по возможности исключать такие точки или снижать последствия их отказа.
Ошибки программного обеспечения
Программное обеспечение может содержать дефекты, которые проявляются только при определенной нагрузке или сочетании условий.
Причиной сбоя могут стать ошибки в коде, утечки памяти, зависания процессов или конфликты между компонентами.
Проблемы также могут возникать после обновления. Новая версия приложения, системного компонента или драйвера может оказаться несовместимой с другими элементами инфраструктуры.
Поэтому изменения в критически важных системах целесообразно предварительно проверять в тестовой среде.
Ошибки конфигурации
Даже исправное оборудование и стабильное ПО могут перестать работать после неверной настройки.
Например, администратор изменяет правило межсетевого экрана и блокирует необходимый трафик. Другая ситуация — изменение маршрутизации, после которого сервис становится недоступным для части пользователей.
Ошибка конфигурации особенно опасна при автоматизированном массовом развертывании: неверный параметр может одновременно попасть на множество узлов.
Поэтому изменения необходимо фиксировать и проверять, а для критичных настроек предусматривать возможность быстрого отката.
Человеческий фактор
Сотрудник может случайно удалить файл, остановить сервис или изменить критичную настройку.
Такие ошибки не всегда связаны с недостатком квалификации. Причиной могут стать высокая нагрузка, недостаточная регламентация операций или отсутствие дополнительной проверки.
Снизить риск помогают разграничение доступа, журналирование действий и формализованные процедуры внесения изменений.
Для критически важных операций может применяться дополнительное подтверждение.
Перегрузка инфраструктуры
Система может быть технически исправна, но перестать справляться с нагрузкой.
Причиной может стать нехватка оперативной памяти, процессорного времени, дискового пространства или пропускной способности сети.
Например, неконтролируемый рост журналов способен заполнить диск. После этого база данных или приложение могут перестать записывать новые данные.
Похожие проблемы возникают при резком росте количества запросов или пользователей.
Поэтому мониторинг должен контролировать не только доступность системы, но и использование ресурсов.
Внешние воздействия
ИТ-системы зависят от физической инфраструктуры. Проблемы с электропитанием, охлаждением или связью способны нарушить работу оборудования.
К серьезным последствиям также могут привести пожар, затопление и другие аварии на площадке.
Для критически важных систем могут использоваться резервные линии связи, источники бесперебойного питания и территориально разнесенные площадки.
Конкретный набор мер зависит от требований к доступности, допустимого времени простоя и характеристик защищаемой системы.
Кибератаки
Сбой может стать следствием кибератаки.
Например, DDoS-атака — распределенная атака типа «отказ в обслуживании» — может исчерпать доступные ресурсы сервиса.
Вредоносное ПО способно остановить процессы, удалить или повредить данные, изменить настройки системы.
Программа-вымогатель может зашифровать файлы и сделать информационную систему недоступной для штатной работы.
Эксплуатация уязвимости также способна вызвать отказ приложения, операционной системы или другого компонента.
В таких ситуациях технический сбой может одновременно быть инцидентом информационной безопасности.
Виды системных сбоев
Для анализа сбои можно классифицировать по источнику.
Аппаратные сбои связаны с физическими компонентами: дисками, памятью, сетевыми интерфейсами, контроллерами и другим оборудованием.
Программные сбои возникают из-за ошибок приложений, операционных систем, драйверов или других программных компонентов.
Сетевые сбои связаны с каналами связи, маршрутизацией, коммутаторами и сетевыми настройками.
Инфраструктурные сбои возникают при проблемах с электропитанием, охлаждением, инженерными системами или площадкой.
Логические сбои затрагивают данные и правила их обработки. Например, повреждение индекса базы данных способно нарушить работу приложения.
Отдельно можно рассматривать сбои, вызванные действиями сотрудников или кибератаками.
По масштабу воздействия можно выделить локальные и каскадные сбои, а также события, затрагивающие значительную часть инфраструктуры.
Локальный сбой затрагивает отдельный объект. Каскадный распространяется через зависимости между компонентами.
Чем сбой системы отличается от отказа
В технической литературе близкие термины могут использоваться по-разному, поэтому при их разграничении важен контекст и выбранная терминология.
Ошибка — error — некорректное состояние системы или результат обработки. Ошибка может существовать внутри системы и некоторое время не быть заметной пользователю.
Неисправность или дефект — fault — причина, которая способна привести к ошибочному состоянию системы.
Например, дефектный модуль памяти может некоторое время не проявлять проблему. При определенных условиях неисправность приведет к ошибке.
Отказ — failure — потеря системой способности выполнять требуемую функцию в соответствии с заданными условиями.
В русскоязычных материалах термины «сбой» и «отказ» могут использоваться близко по смыслу, однако конкретные определения зависят от принятой методики и стандартов.
Отдельное понятие — инцидент информационной безопасности. Не каждый технический сбой относится к таким инцидентам.
Например, отказ накопителя вследствие естественного износа может рассматриваться как эксплуатационный инцидент.
Если же сбой вызван атакой, приводит к нарушению защищенности информации или сопровождается признаками вредоносной активности, событие может быть классифицировано как ИБ-инцидент.
Критерии классификации следует закреплять во внутренних регламентах организации.
Как сбой системы влияет на информационную безопасность
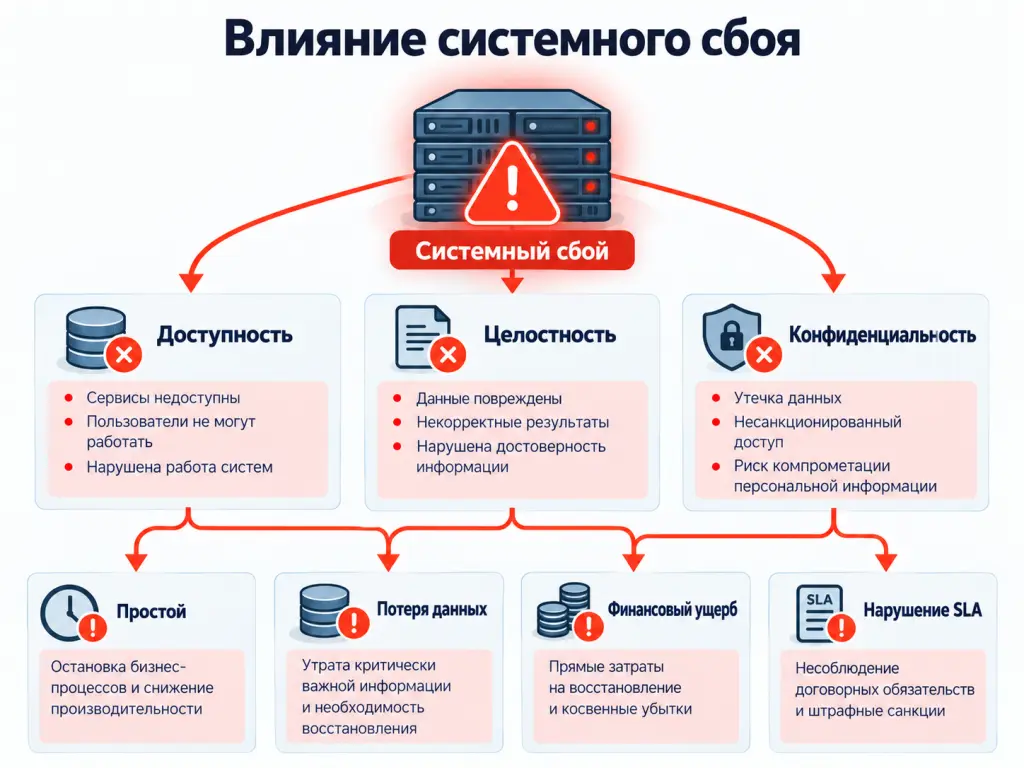
Информационную безопасность часто рассматривают через три свойства информации: конфиденциальность, целостность и доступность.
Эта модель известна как CIA triad — Confidentiality, Integrity, Availability.
При системном сбое наиболее очевидным последствием становится нарушение доступности. Однако влияние может затронуть и другие свойства информации.
Нарушение доступности
Пользователи не могут открыть приложение, получить данные или выполнить необходимую операцию.
Если отказ затрагивает средство защиты, последствия могут быть шире.
Например, недоступность системы аутентификации способна заблокировать доступ легитимным пользователям. В другом сценарии отказ компонента контроля может привести к тому, что предусмотренные механизмы защиты перестанут работать корректно.
Особенно существенны такие последствия для сервисов, которые должны работать непрерывно или имеют жесткие требования к доступности.
Нарушение целостности
Сбой может повредить данные или привести к их некорректной обработке.
Например, операция записи прерывается до завершения. В результате часть данных обновляется, а часть остается в предыдущем состоянии.
Такая ситуация может быть сложнее для обнаружения, чем полная недоступность: пользователь продолжает работать и не всегда сразу замечает, что информация стала некорректной.
Поэтому после серьезного отказа важно проверить не только доступность системы, но и состояние данных.
Риск нарушения конфиденциальности
Системный сбой также может создать условия для нарушения конфиденциальности.
Например, при аварийном переключении система может применить некорректные правила доступа.
Другой сценарий — восстановление более старой конфигурации, в которой отсутствуют актуальные ограничения.
Поэтому процедуры восстановления должны включать проверку настроек безопасности и контроля доступа.
Одного восстановления доступности сервиса недостаточно: необходимо убедиться, что система работает корректно и с предусмотренным уровнем защиты.
К каким последствиям может привести сбой системы
Последствия зависят от роли системы в бизнес-процессах.
Сбой внутреннего тестового сервера обычно менее критичен, чем отказ системы, от которой зависит производство, проведение платежей или другой основной процесс.
Возможные последствия:
- простой сотрудников и бизнес-процессов;
- потеря или повреждение данных;
- нарушение соглашения об уровне сервиса — Service Level Agreement, SLA;
- финансовые потери;
- остановка производства;
- ухудшение обслуживания клиентов;
- нарушение договорных или нормативных требований;
- репутационный ущерб;
- переход технического сбоя в ИБ-инцидент.
Часть последствий может проявиться не сразу. Например, сервис быстро восстановился, но нарушение целостности данных обнаружили позднее.
Поэтому после серьезного события целесообразно проводить технический разбор.
Он должен отвечать не только на вопрос «что сломалось», но и объяснять, почему это произошло и какие условия сделали сбой возможным.
Примеры сбоев системы
Рассмотрим несколько типовых сценариев.
Сценарий 1. Отказ дисковой подсистемы.
В системе хранения выходят из строя несколько накопителей. Имеющееся резервирование не покрывает такой сценарий. Корпоративное приложение теряет доступ к данным и становится недоступным.
Сценарий 2. Неудачное обновление.
Компания устанавливает новую версию системного компонента. После перезапуска часть серверов не запускается из-за несовместимости.
Сценарий 3. Ошибка конфигурации сети.
Администратор изменяет настройки маршрутизации. Часть сетей теряет доступ к корпоративному приложению, хотя само приложение продолжает работать.
Сценарий 4. Атака на доступность.
DDoS-атака создает нагрузку, превышающую возможности инфраструктуры. Ресурсы сервисов исчерпываются, и они перестают отвечать на запросы пользователей.
Эти примеры показывают: одинаковое внешнее проявление может быть вызвано разными причинами.
По одной только недоступности сервиса нельзя определить, что именно произошло.
Как обнаруживают системные сбои
Для раннего обнаружения сбоев необходим постоянный контроль состояния инфраструктуры.
Базовая проверка отвечает на вопрос, доступен ли сервис. Более развитая система мониторинга помогает выявить причины ухудшения его работы и признаки приближающегося отказа.
Обычно организации используют несколько источников данных.
Система мониторинга контролирует серверы, сетевые устройства и приложения. Она отслеживает загрузку процессора, использование памяти и дискового пространства, задержки и другие показатели.
Журналы событий помогают восстановить последовательность действий и изменений перед сбоем.
Полезны также проверки сервиса с точки зрения пользователя. Они показывают не только состояние отдельного сервера, но и фактическую доступность требуемой функции.
Для анализа событий безопасности применяют SIEM — системы управления информацией и событиями безопасности.
SIEM может быть полезна, если технический сбой сопровождается признаками кибератаки или другой подозрительной активности.
В распределенных приложениях также используют платформы наблюдаемости, объединяющие метрики, журналы и трассировки запросов.
Такие данные помогают анализировать состояние и зависимости сложных систем.
Задача мониторинга — по возможности обнаруживать признаки проблемы до полного отказа.
Например, предупреждение о приближении диска к заполнению позволяет принять меры до того, как нехватка свободного пространства остановит базу данных или приложение.
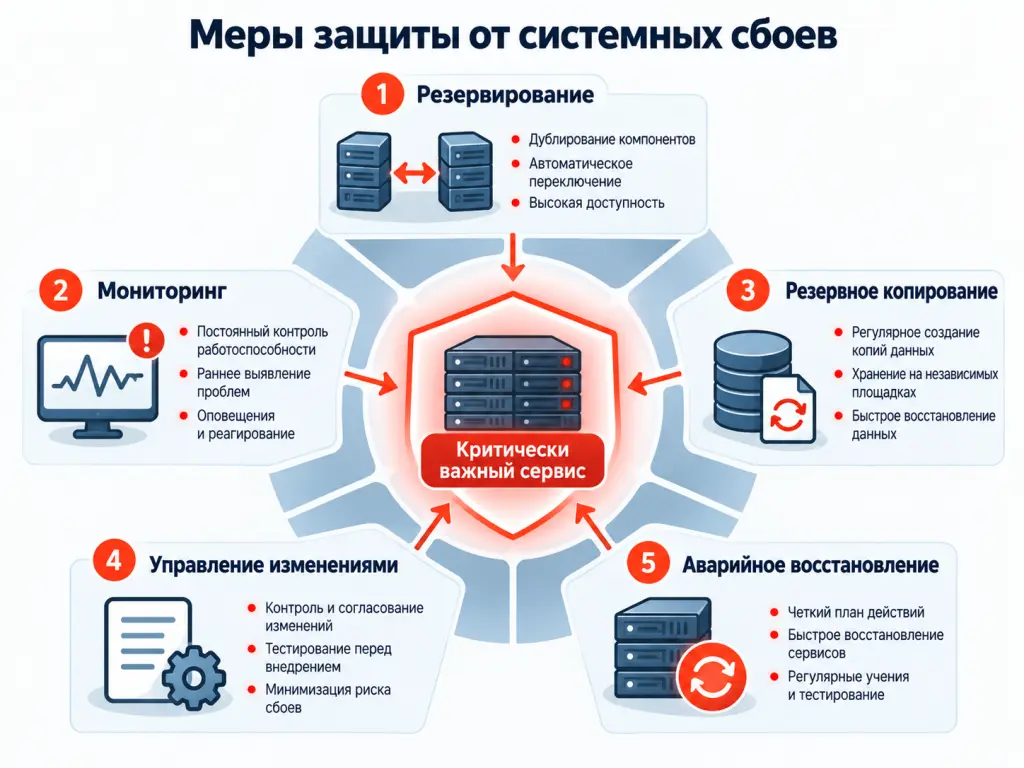
Как снизить вероятность системных сбоев
Полностью исключить сбои невозможно. Задача ИТ- и ИБ-команд — снизить вероятность отказа и ограничить его последствия.
Отказоустойчивая архитектура
Критически важные компоненты необходимо резервировать в соответствии с требованиями к доступности системы.
Это могут быть серверы, сетевые каналы, источники питания, системы хранения и площадки.
Недостаточно просто добавить резервный компонент. Необходимо проверить, что механизм переключения работает в предусмотренных сценариях.
Поэтому отказоустойчивость следует подтверждать тестированием.
Резервное копирование
Резервное копирование не предотвращает сбой, но помогает восстановить данные после него.
Резервные копии необходимо создавать регулярно и хранить так, чтобы отказ или компрометация основной системы не сделали их одновременно недоступными.
Необходимо также проверять возможность восстановления.
Само наличие резервной копии еще не гарантирует, что из нее удастся восстановить работоспособную систему.
Для критически важных данных следует регулярно тестировать процедуры восстановления.
Мониторинг
Мониторинг помогает обнаруживать признаки неисправностей и деградации системы до полного отказа.
Следует контролировать загрузку ресурсов, состояние оборудования, ошибки приложений и сетевые показатели.
Особенно важны метрики, отражающие фактическую доступность и качество работы сервиса для пользователя.
Сервер может продолжать работать, хотя приложение уже отвечает с недопустимой задержкой или не выполняет часть операций.
Управление изменениями
Обновления и изменения конфигурации могут становиться причиной сбоев.
Поэтому изменения необходимо планировать, тестировать и документировать.
Для критически важных систем следует предусматривать тестовую среду и план отката.
Изменения также можно внедрять поэтапно, чтобы потенциальная ошибка не затронула всю инфраструктуру одновременно.
Управление уязвимостями
Уязвимость может стать причиной системного сбоя, если ее используют для атаки.
Поэтому организации необходимо выявлять и устранять уязвимости с учетом их критичности и роли затронутых систем.
Особое внимание следует уделять компонентам, доступным из внешних сетей.
При этом исправления также необходимо тестировать: обновление может вызвать проблемы совместимости или другие нарушения работы.
Планы аварийного восстановления
Для критически важной инфраструктуры разрабатывают Disaster Recovery Plan — план аварийного восстановления, или DRP.
Он определяет порядок восстановления систем после серьезного отказа.
Более широкий Business Continuity Plan — план обеспечения непрерывности бизнеса, или BCP — описывает, как организация будет поддерживать ключевые процессы во время кризисной ситуации.
Такие планы необходимо регулярно проверять на практике.
Документ должен быть известен ответственным сотрудникам до возникновения аварийной ситуации, а предусмотренные в нем действия — отработаны заранее.
Что делать при сбое системы
При сбое важно избегать несогласованных действий.
Поспешные изменения могут скрыть причину проблемы, затруднить расследование или увеличить последствия.
Базовый порядок действий:
- Обнаружить и локализовать проблему. Определить, какие компоненты работают некорректно.
- Определить затронутые сервисы. Оценить реальный масштаб события и зависимости между системами.
- Ограничить распространение сбоя. При необходимости изолировать неисправный или скомпрометированный компонент.
- Восстановить критичные функции. Использовать резервирование, откат изменений или восстановление из резервных копий.
- Проверить данные и безопасность. Убедиться, что система не только доступна, но и работает корректно, а механизмы защиты восстановлены.
- Установить первопричину. Не ограничиваться устранением внешнего проявления проблемы.
- Предотвратить повторение. При необходимости изменить архитектуру, конфигурацию или эксплуатационные процедуры.
Если есть признаки кибератаки, к реагированию необходимо подключить специалистов по информационной безопасности.
Например, одновременный отказ нескольких систем может оказаться не обычной технической неисправностью, а следствием вредоносной активности.
В такой ситуации перезапуск или изменение системы без предварительной фиксации ее состояния может затруднить расследование и привести к потере значимых данных.
Поэтому процедуры эксплуатации и реагирования на ИБ-инциденты должны быть согласованы между собой.
Почему важно искать первопричину
Восстановление сервиса — только одна из задач после серьезного сбоя.
Если команда устранила внешнее проявление проблемы, но не ее причину, событие может повториться.
Для таких случаев применяют анализ первопричины.
Команда изучает события перед отказом, зависимости системы, изменения конфигурации и действия персонала.
Например, база данных остановилась из-за заполненного диска.
Непосредственная причина — отсутствие свободного места. Однако дальнейший анализ показывает, что диск заполнили журналы приложения.
Затем необходимо выяснить, почему объем журналов начал быстро расти.
Допустим, после обновления приложение стало многократно записывать одно и то же сообщение об ошибке.
В такой ситуации очистка диска устраняет последствие. Исправление причины неконтролируемой записи в журналы снижает вероятность повторения сбоя.
Анализ первопричины позволяет выявлять системные проблемы и корректировать архитектуру или эксплуатационные процессы.
Роль системного интегратора в предотвращении и устранении сбоев
В сложной инфраструктуре причины сбоя нередко находятся на стыке нескольких систем: серверов, сетевого оборудования, приложений и средств информационной безопасности. Поэтому при профилактике и устранении таких событий важно учитывать не только отдельные компоненты, но и связи между ними.
Системный интегратор может участвовать в обследовании инфраструктуры, проектировании системы защиты и проверке работы ее компонентов.
Для обнаружения событий, связанных с информационной безопасностью, могут применяться SIEM-системы. Их внедрение включает обследование инфраструктуры, подключение источников событий, настройку правил и интеграций. Это особенно полезно, когда необходимо отличить обычный технический отказ от события, которое может быть связано с атакой.
Еще одно направление — резервное копирование. Оно не предотвращает системный сбой, но позволяет снизить последствия потери или повреждения данных и восстановить их после отказа. На сайте Комрунет представлены решения для централизованного резервного копирования и восстановления, в том числе для серверов, баз данных и виртуальной инфраструктуры.
Таким образом, участие системного интегратора может быть полезно на разных этапах работы со сбоями: при обследовании инфраструктуры и проектировании защиты, внедрении средств мониторинга и резервного копирования, сопровождении систем и анализе причин уже произошедших отказов.
Главное о сбое системы
Сбой системы означает, что информационная система полностью или частично теряет способность выполнять предусмотренные функции либо выполняет их некорректно.
Причиной могут стать неисправность оборудования, ошибка ПО, неверная настройка, действия сотрудника или кибератака.
С точки зрения информационной безопасности наиболее очевидный риск связан с доступностью. Однако сбой также способен повредить данные или нарушить работу механизмов контроля доступа.
К основным мерам относятся резервирование, мониторинг, резервное копирование и управление изменениями.
Для критически важных систем необходимы заранее подготовленные и проверенные процедуры восстановления.
Восстановление сервиса не завершает работу со сбоем: после серьезного события необходимо определить первопричину и принять меры, снижающие вероятность повторения проблемы.
FAQ
Что такое системный сбой простыми словами?
Это ситуация, когда система перестает работать предусмотренным образом. Она может полностью остановиться или потерять отдельные функции.
Чем сбой отличается от ошибки?
Ошибка — это некорректное внутреннее состояние или результат обработки. Сбой — внешне наблюдаемое нарушение работы системы или предоставляемой ею функции. Точное разграничение терминов зависит от используемой методики.
Всегда ли системный сбой считается инцидентом информационной безопасности?
Нет. Например, отказ оборудования может оставаться эксплуатационным инцидентом. Если сбой связан с атакой, нарушением защищенности информации или другими признаками ИБ-инцидента, его классификация может измениться.
Можно ли полностью защититься от системных сбоев?
Полностью исключить сбои нельзя. Можно снизить их вероятность и уменьшить последствия с помощью отказоустойчивой архитектуры, мониторинга, резервного копирования и заранее проверенных процедур восстановления.
Что важнее после сбоя: быстро восстановить систему или найти причину?
Приоритет действий зависит от ситуации, но обычно сначала необходимо стабилизировать систему и восстановить критичные функции. После этого следует установить первопричину, иначе проблема может повториться.